 0
 0
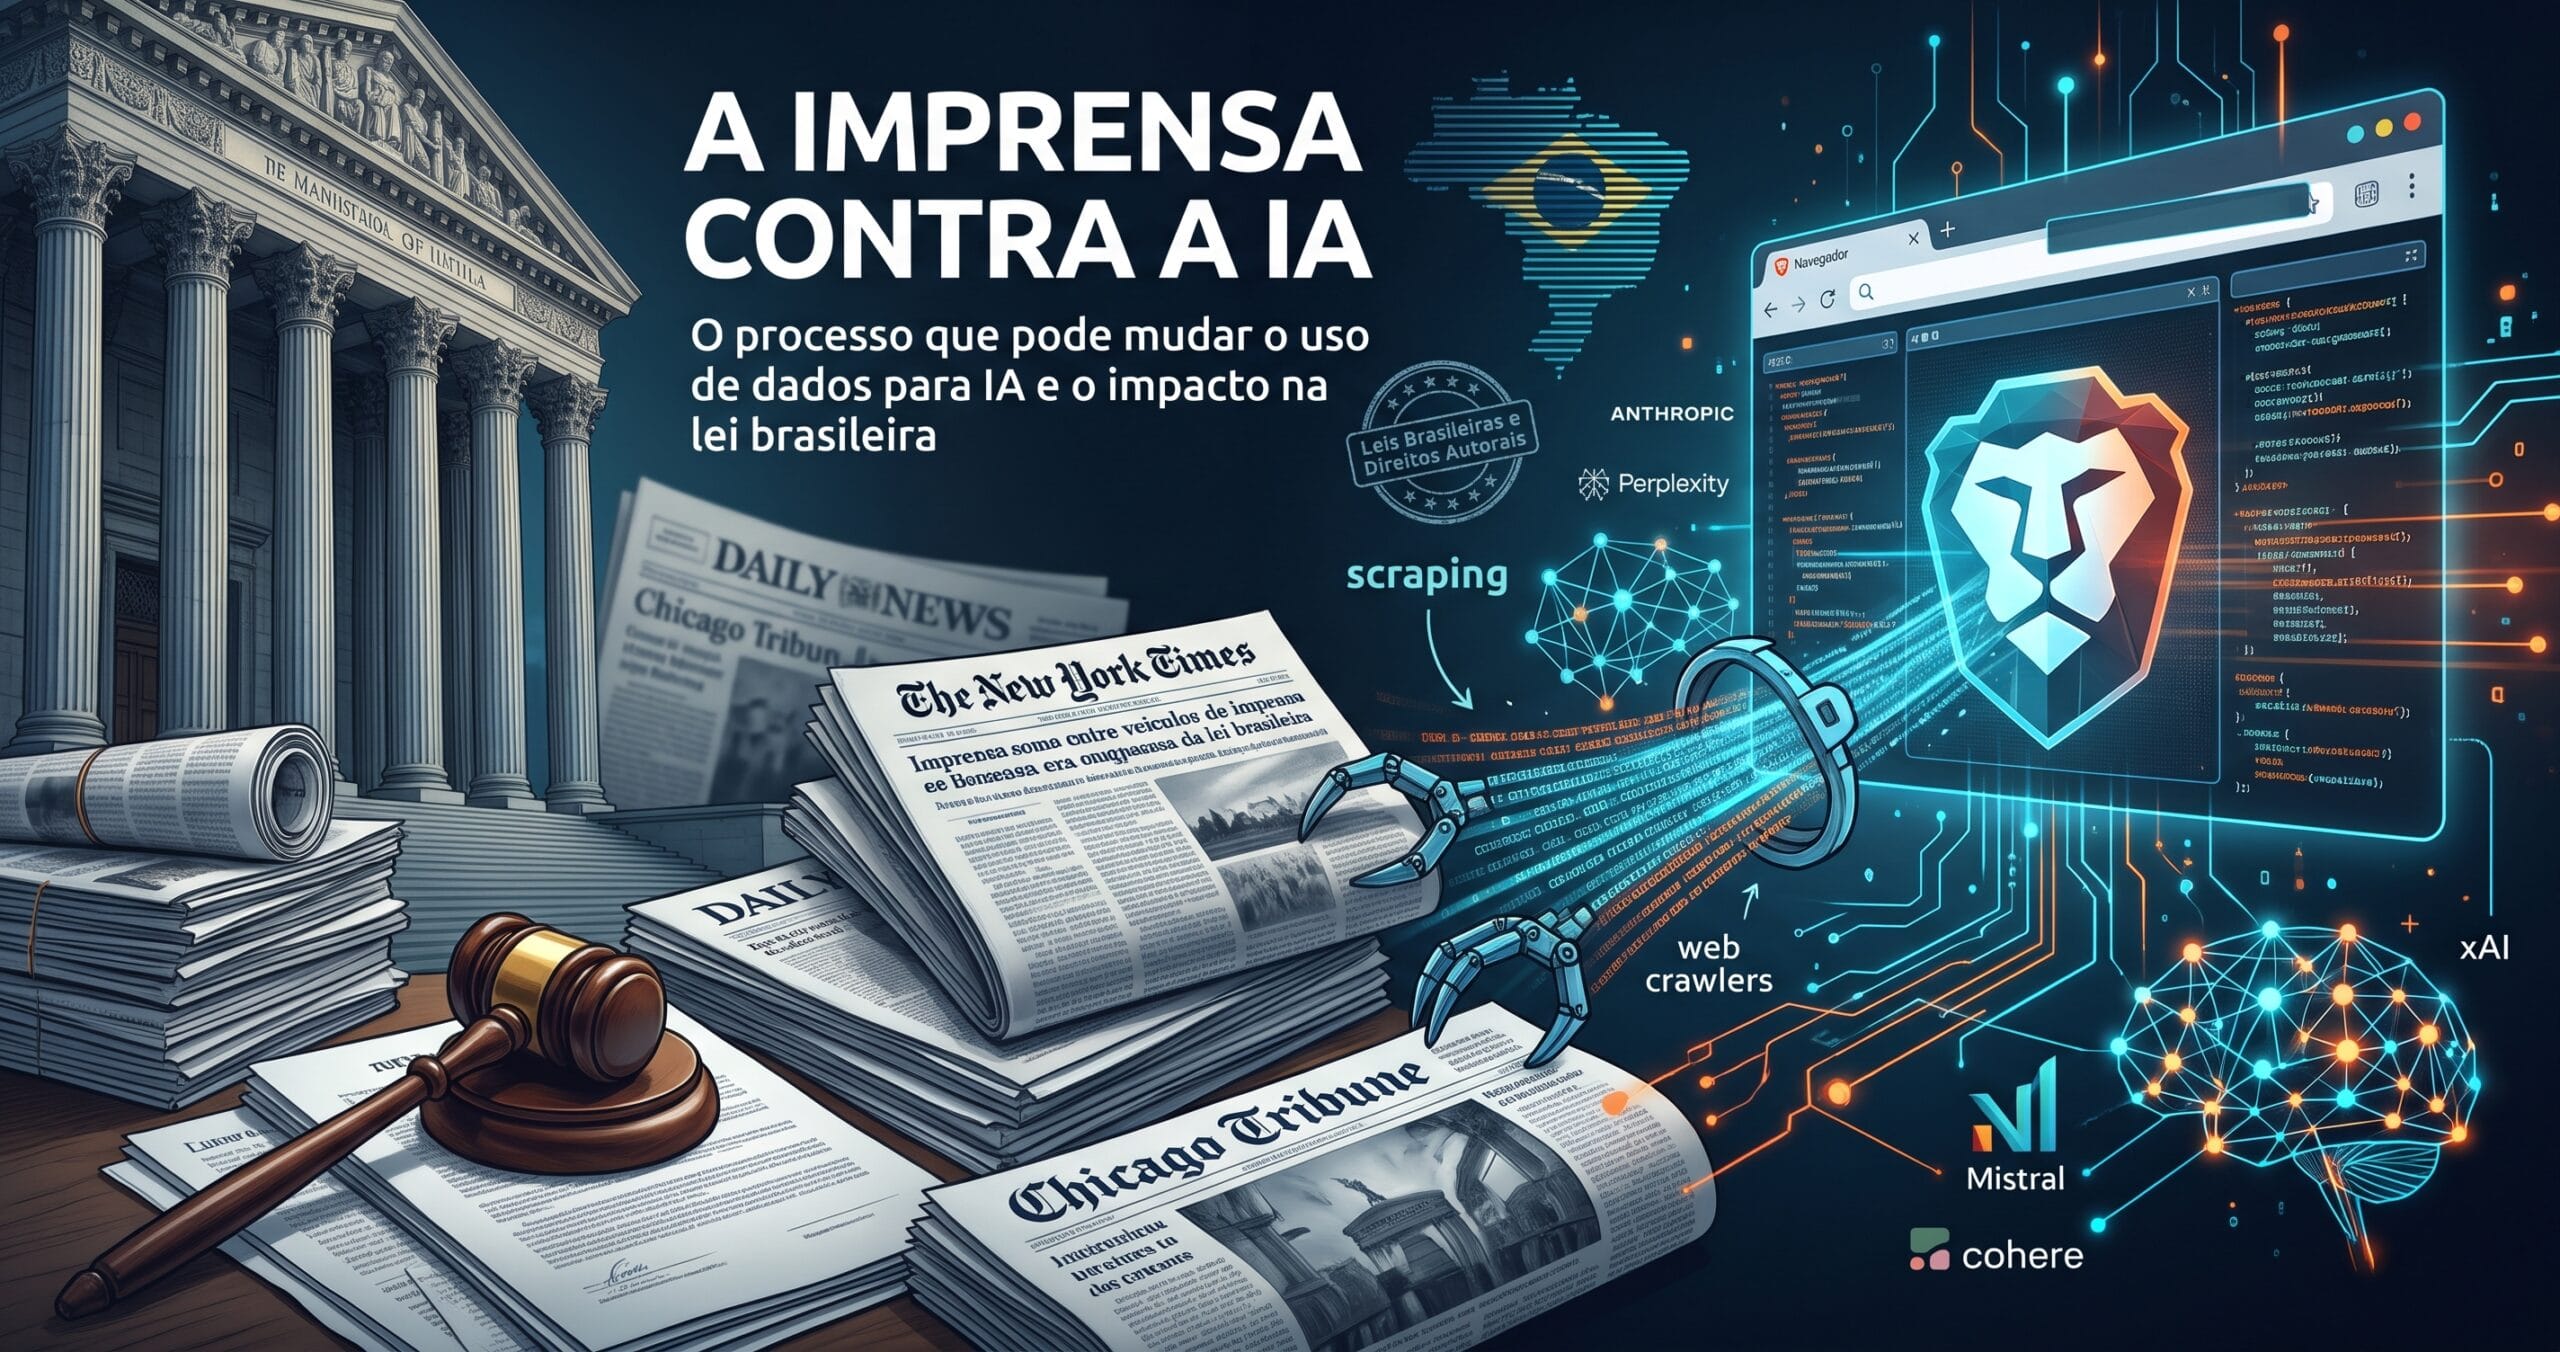
Segunda-feira, 2 de novembro de 2026, foi um dia ruim para a Brave Software, a empresa por trás do navegador que promete bloquear anúncios e proteger sua privacidade. Em uma corte federal de Manhattan, o The New York Times abriu um processo acusando a empresa de fazer scraping de conteúdo protegido por direitos de autor e de distribuir esse material a clientes de inteligência artificial, entre eles Anthropic, Perplexity, Mistral, xAI e Cohere. No mesmo dia, outros três veículos, o Daily News, o Chicago Tribune e o Orlando Sentinel, entraram com uma ação parecida.
A tese dos jornais, segundo o próprio texto do processo, é pesada: a Brave teria montado um índice de mais de 30 bilhões de páginas da web usando um rastreador não identificado, criado justamente para que os editores não conseguissem bloqueá-lo. O navegador ainda contornaria paywalls e bloquearia os anúncios dos próprios veículos, enquanto vende publicidade por conta própria. Os autores pedem liminar e indenização por danos. A Brave não se manifestou até a publicação da notícia original.
Para quem acompanha direito digital, a pergunta que fica não é só “quem vai ganhar essa ação nos Estados Unidos”. É outra: se um navegador fizesse isso com conteúdo brasileiro, o que diria a nossa lei?
O que está sendo alegado, sem floreio
Vale separar com cuidado o que a notícia confirma do que ainda é só alegação de uma das partes, porque o processo acaba de ser protocolado e não foi julgado.
O que está no processo, segundo a reportagem:
- a Brave teria coletado (feito scraping de) conteúdo protegido por direitos de autor pertencente aos jornais autores da ação;
- esse conteúdo teria sido repassado a empresas de IA que são clientes da Brave, entre elas Anthropic, Perplexity, Mistral, xAI e Cohere;
- a coleta teria sido feita por um crawler desenhado para não ser identificável nem bloqueável pelos editores;
- o navegador ofereceria um recurso que contorna paywalls dos sites visitados;
- a Brave bloquearia anúncios dos editores no navegador, mas venderia seus próprios anúncios.
O pedido é de liminar e indenização por danos. A reportagem não especifica, além da referência genérica a violação de direitos de autor, qual dispositivo legal exato está sendo invocado nos Estados Unidos, então não vou inventar uma tese jurídica americana específica aqui. O que interessa para este post é o fato em si, e como ele seria tratado se acontecesse por aqui.
No Brasil, isso seria legal?
A primeira coisa a esclarecer é que esse não é, tecnicamente, um problema de LGPD. Dados pessoais e direitos de autor são categorias diferentes: a Lei Geral de Proteção de Dados protege a pessoa natural identificável, não o texto de uma reportagem do New York Times. Quando o assunto é “fulano coletou texto e imagem de terceiros sem autorização”, a lei que entra em cena é a Lei de Direitos Autorais (Lei 9.610/1998).
E a LDA trata reprodução de forma bem ampla. O art. 5º, VI, da lei define reprodução incluindo “qualquer armazenamento permanente ou temporário por meios eletrônicos”. Isso cobre, em tese, o próprio ato de copiar o conteúdo de uma página para um índice ou para um conjunto de dados de treinamento, mesmo que esse armazenamento seja transitório.
Do outro lado, a lei também prevê usos livres, que não precisam de autorização do autor, no art. 46. Mas essa lista é enxuta e pontual: entre os exemplos, está a reprodução de pequenos trechos de obras preexistentes (inciso VIII), não o aproveitamento de um banco inteiro de conteúdo jornalístico. Não existe, nessa lista, uma hipótese pensada para mineração de dados em escala ou para treinamento de modelos de IA. Em outras palavras, se a Brave tivesse feito isso com um jornal brasileiro, a alegação de violação de direitos autorais teria, pelo menos à primeira vista, um fundamento sólido na nossa própria lei, sem precisar importar nenhuma teoria americana.
Aqui vai o ponto que mais interessa para quem trabalha com tecnologia: o Brasil ainda não tem uma lei específica tratando do uso de conteúdo protegido para treinar modelos de inteligência artificial. O projeto que tentaria preencher essa lacuna, o PL 2.338/2023 (conhecido como o Marco Legal da IA), foi aprovado pelo Senado em dezembro de 2024, está desde março de 2025 na Câmara dos Deputados, onde uma comissão especial foi instalada em maio de 2025 com o deputado Aguinaldo Ribeiro (PP-PB) como relator, e, até a pesquisa feita para este post, ainda aguardava parecer, sem data de votação marcada. Ou seja: enquanto esse projeto não avança, qualquer disputa sobre IA treinada com conteúdo protegido no Brasil cai direto na Lei de Direitos Autorais de 1998, que nunca foi escrita pensando em redes neurais.
O que isso muda para quem desenvolve ou contrata IA
Para empresas brasileiras de tecnologia e para escritórios que assessoram esse setor, o caso NYT x Brave é um bom lembrete de três pontos práticos:
Primeiro, a origem dos dados de treinamento importa juridicamente, não é só uma questão de ética ou de boa prática. Se uma empresa de IA brasileira treina (ou contrata treinamento) com conteúdo coletado de terceiros sem licença, ela se expõe ao mesmo tipo de alegação que a Brave está enfrentando agora, com base na nossa própria Lei de Direitos Autorais, independentemente do que acontecer no Marco Legal da IA.
Segundo, contratos de licenciamento de conteúdo para treinamento de modelos deixaram de ser um detalhe de rodapé. Editoras, bancos de imagens e provedores de dados já cobram, e processam, por isso. Negociar essas licenças antes de treinar, não depois de ser notificado, é o caminho mais barato.
Terceiro, para empresas que distribuem ou revendem acesso a modelos de IA treinados por terceiros (como a Brave fazia, segundo a acusação, ao repassar dados a Anthropic, Perplexity, Mistral, xAI e Cohere), vale mapear a origem do conteúdo usado por esses parceiros. Ser apenas o “distribuidor” não necessariamente afasta a responsabilidade, se a coleta original já era irregular.
Conclusão
O processo do NYT contra a Brave ainda vai levar meses, talvez anos, para ter um desfecho nos Estados Unidos. Mas o caso já cumpre uma função imediata por aqui: mostra que a conta de treinar IA com conteúdo de terceiros, sem conversar antes com quem criou esse conteúdo, está chegando. No Brasil, essa conta hoje passa pela Lei de Direitos Autorais de 1998, não por uma lei de IA que ainda não saiu do papel.
Assine a newsletter do LawGeek para acompanhar como esse debate evolui no Congresso e nos tribunais.
Dr. Luiz Guedes da Luz Neto é advogado, OAB/PB 11.005.
FAQ — Perguntas Frequentes
Scraping de conteúdo para treinar IA é crime no Brasil?
A notícia trata de uma disputa cível, não criminal, e isso vale também para uma situação equivalente no Brasil: a discussão giraria em torno de responsabilidade civil por violação de direitos autorais (Lei 9.610/1998), com pedido de indenização e, eventualmente, de retirada do conteúdo, não de uma ação penal.
A LGPD protege o conteúdo de um jornal contra scraping para treinar IA?
Não diretamente. A LGPD protege dados pessoais de pessoas naturais identificáveis. Reportagens, textos editoriais e outros conteúdos protegidos por direitos de autor são tutelados pela Lei 9.610/1998 (Lei de Direitos Autorais), não pela LGPD, ainda que um mesmo caso possa, em tese, envolver as duas leis em pontos diferentes.
O Marco Legal da IA (PL 2.338/2023) já resolve essa questão no Brasil?
Ainda não. Até a pesquisa feita para este post, o PL 2.338/2023 estava na Câmara dos Deputados, em comissão especial, aguardando parecer do relator, sem data de votação definida, depois de aprovado pelo Senado em dezembro de 2024. Convém confirmar a tramitação atualizada antes de tomar qualquer decisão com base nesse projeto, já que o cronograma legislativo pode mudar.
Que lei se aplicaria hoje, no Brasil, a um caso como o da Brave?
Hoje, na ausência de uma lei específica sobre treinamento de IA, a base legal mais direta é a Lei de Direitos Autorais (Lei 9.610/1998), cujo art. 5º, VI, define reprodução de forma ampla (incluindo armazenamento eletrônico temporário) e cujo art. 46 traz uma lista restrita de usos livres, que não contempla mineração de dados em escala para treinar modelos de IA.


Receba a Pauta LawGeek
Uma curadoria do que muda em Direito e Tecnologia (IA, LGPD, cripto e legaltech), explicada na prática, direto no seu e-mail.